5 Detección y Tratamiento de Anomalías: Valores Perdidos y Atípicos
5.1 La Filosofía de las Anomalías en Minería de Datos
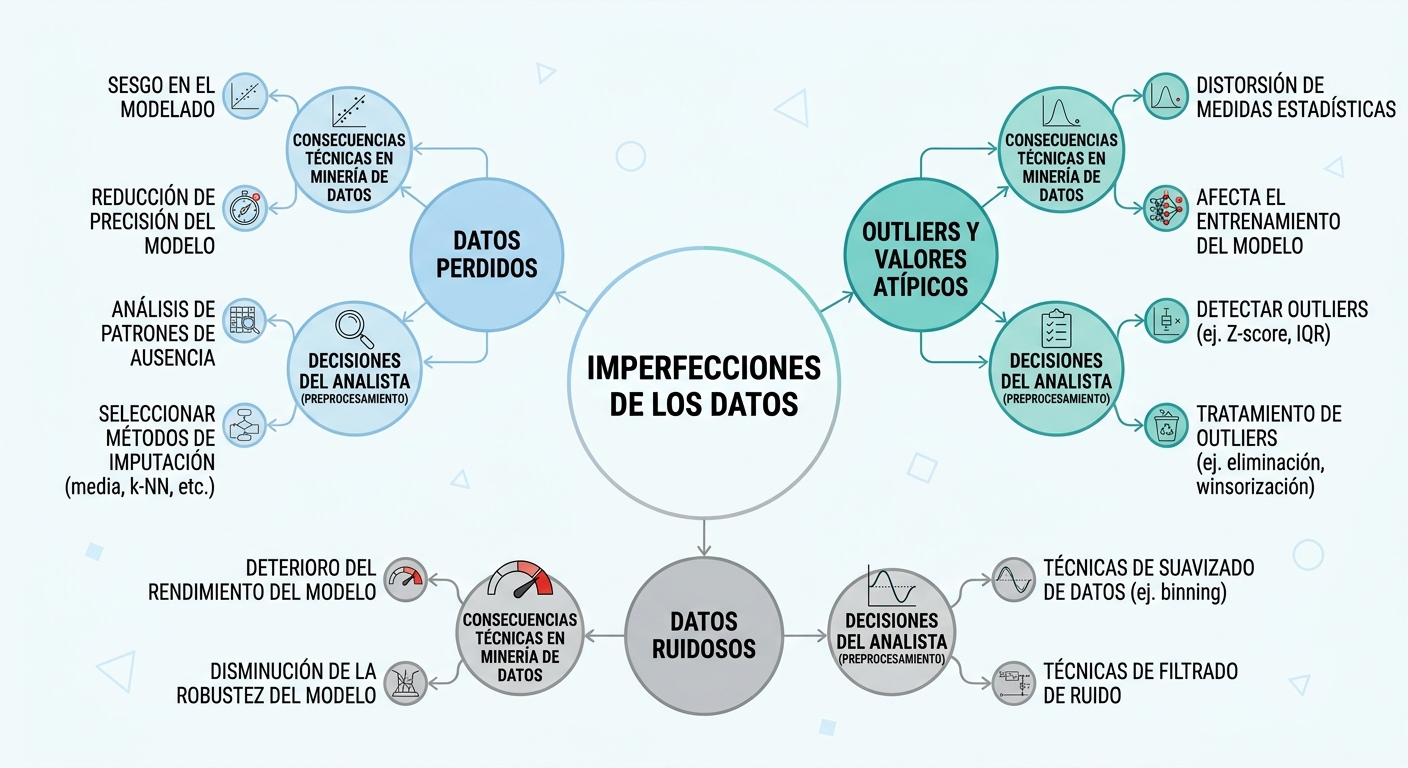
En el análisis de datos del mundo real, la presencia de anomalías e imperfecciones es una regla y no una excepción. Como señala el estadístico David J. Hand, “debemos desconfiar de cualquier conjunto de datos (grande o pequeño) que parezca perfecto”, ya que la limpieza absoluta suele ocultar problemas de recolección o preprocesamiento inadecuado. El analista debe comprender que la falta de información es información, y que el comportamiento inusual de una variable puede revelar patrones estratégicos cruciales, como fraudes o fallas de sistema, si se examina con el rigor metodológico apropiado.
En el marco del proceso de Descubrimiento de Conocimiento (KDD), las anomalías se dividen principalmente en dos grandes categorías: valores perdidos (missing values), que representan la ausencia física de mediciones en ciertos atributos, y valores atípicos (outliers), que son observaciones que se desvían de manera extrema de los patrones de variabilidad del resto del conjunto (Tan et al. 2019). Tratar estas imperfecciones de forma mecánica sin evaluar su origen introduce sesgos que invalidan cualquier modelado algorítmico posterior (Shmueli et al. 2018).
5.2 Detección y Tratamiento de Valores Atípicos (Outliers)
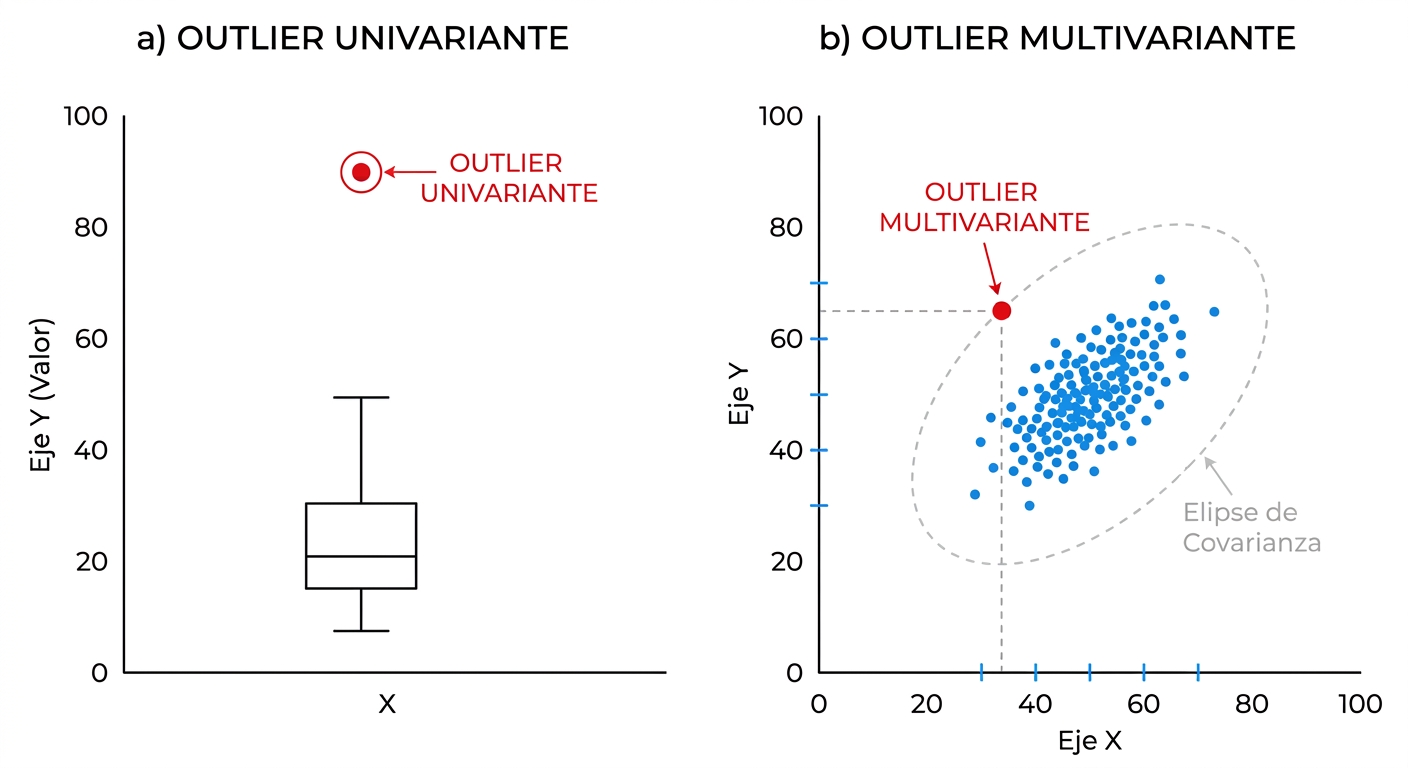
Un valor atípico es una observación que presenta una desviación extrema respecto al patrón general de variabilidad observado en el conjunto de datos (Tan et al. 2019). La investigación de outliers exige distinguir rigurosamente entre anomalías univariantes y multivariantes (Johnson and Wichern 2014).
5.2.1 Enfoque Univariante: Detección y Mitigación
El análisis univariante examina el comportamiento de los atributos de forma aislada, sin considerar sus interrelaciones (Johnson and Wichern 2014).
5.2.1.1 Métodos de Detección
- Regla del Rango Intercuartílico (IQR): Define límites de control basados en la dispersión robusta de los datos. El rango intercuartílico es \(IQR = Q3 - Q1\). Los límites inferior y superior se establecen como: \[[\text{Límite Inferior}, \text{Límite Superior}] = [Q1 - 1.5 \times IQR, \quad Q3 + 1.5 \times IQR]\]. Una aplicación visual es usar un diagrama de cajas.
Otro camino es analizar transformaciones sobre los datos para identificar valores alejados de los esperados, los mas comunes:
Mide la distancia estandarizada de cada observación respecto a la media muestral (\(\bar{x}\)) en unidades de desviación estándar (\(s\)).
Fórmula: \[z_i = \frac{x_i - \bar{x}}{s}\]
- \(\bar{x}\): Media muestral.
- \(s\): Desviación estándar muestral.
Una alternativa robusta al Z-score que sustituye la media por la mediana y la desviación estándar por la MAD, haciéndola inmune al impacto de los propios datos atípicos.
Fórmula: \[\text{Score}_i = \frac{x_i - \tilde{x}}{\text{MAD}(x)}\]
Donde:
- \(\tilde{x}\): Mediana de los datos, \(\text{mediana}(x)\).
- \(\text{MAD}(x)\): \(1.4826 \cdot \text{mediana}(|x_i - \tilde{x}|)\) (El factor \(1.4826\) ajusta la escala para aproximarse a la desviación estándar de una distribución normal).
En R se puede usar la librería outliers para la identificación y la creación de los scores.
5.2.1.2 Prácticas Comunes de Solución
- Tratamiento de Recorte (Trimming): Eliminar físicamente las observaciones identificadas como outliers univariantes. Se recomienda únicamente si la anomalía es un error de medición irreversible.
- Winsorización: Reemplazar los valores extremos que superan los límites de percentiles establecidos por los valores límite de dichos percentiles, preservando el tamaño original del dataset.
- Transformaciones Matemáticas: Aplicar funciones como el logaritmo natural (\(\log(x)\)) para comprimir la escala de los valores extremadamente altos, reduciendo la asimetría de la distribución.
5.2.2 Enfoque Multivariante: La Dimensión Compleja
Un registro puede poseer valores perfectamente típicos si se examinan sus variables de forma aislada, pero representar una anomalía severa cuando se analiza el comportamiento conjunto de todos sus atributos (Johnson and Wichern 2014).
5.2.2.1 Visualización Avanzada: matplot y Chernoff
Para diagnosticar anomalías multivariantes de manera intuitiva, el analista puede recurrir a representaciones gráficas especializadas de alta dimensionalidad (Johnson and Wichern 2014):
- Gráficos de Perfiles con
matplot(): Permiten trazar las observaciones como líneas quebradas a lo largo de los ejes de las variables del dataset, facilitando la identificación de registros que poseen perfiles o tendencias contradictorias respecto al comportamiento general. - Caras de Chernoff: Mapean atributos cuantitativos a rasgos faciales (forma de la cara, tamaño de los ojos, curvatura de la boca). Permite al ojo humano reconocer de inmediato rostros con expresiones extrañas o aberrantes que representan outliers complejos .
Uso de gráficos de perfil paralelos sobre las variables continuas del dataset iris:
# Seleccionar y estandarizar las columnas numéricas de iris
datos_iris_m <- scale(iris[, 1:4])

# Configurar un gráfico de perfil paralelo
matplot(t(datos_iris_m), type = "l", lty = 1, col = rgb(0, 0, 0, 0.15),
        xlab = "Variables Continuas", ylab = "Valores Estandarizados",
        main = "Gráfico de Perfil Multivariante (Iris)")
Representación gráfica icónica utilizando el paquete especializado aplpack:
# Instalar y cargar librería aplpack si no está disponible
library(aplpack)

# Tomar una muestra representativa de observaciones
muestra_caras <- iris[c(1:5, 51:55, 101:105), 1:4]

# Dibujar caras de Chernoff mapeando variables numéricas a rasgos faciales
faces(muestra_caras, face.type = 1,
      main = "Rostros de Chernoff: Identificación Visual de Outliers")
5.2.2.2 Test multivariantes
- Determinante de Covarianza Mínima (MCD)
Dado un conjunto de \(n\) observaciones en \(p\) dimensiones, \(X \in \mathbb{R}^{n \times p}\), el estimador MCD busca encontrar un subconjunto \(H \subset \{1, \dots, n\}\) de tamaño \(h\) (donde \(\frac{n+p+1}{2} \le h < n\), habitualmente \(h = \lfloor 0.75n \rfloor\)) que minimice el determinante de la matriz de covarianza muestral calculada sobre \(H\):
\[\min_{H} \det(\mathbf{S}_H)\]
Los estimadores robustos de localización (\(\boldsymbol{\hat{\mu}}_{\text{MCD}}\)) y dispersión (\(\mathbf{S}_{\text{MCD}}\)) corresponden a la media y covarianza calculadas exclusivamente sobre el subconjunto óptimo \(H\):
\[\boldsymbol{\hat{\mu}}_{H} = \frac{1}{h} \sum_{i \in H} x_i\]
\[\mathbf{S}_H = \frac{1}{h - 1} \sum_{i \in H} (x_i - \boldsymbol{\hat{\mu}}_H)(x_i - \boldsymbol{\hat{\mu}}_H)^T\]
Tras aplicar un factor de corrección por consistencia a \(\mathbf{S}_H\), la Distancia de Mahalanobis Robusta para cada observación \(x_i\) se define como:
\[d_i = \sqrt{(x_i - \boldsymbol{\hat{\mu}}_{\text{MCD}})^T \mathbf{S}_{\text{MCD}}^{-1} (x_i - \boldsymbol{\hat{\mu}}_{\text{MCD}})}\]
Un punto \(x_i\) se clasifica como outlier si \(d_i^2 > \chi^2_{p,\, 1-\alpha}\).
Ejemplo en R (MCD)
install.packages("robustbase")
library(robustbase)

set.seed(42)
n <- 200
p <- 2
datos_sanos <- matrix(rnorm(n * p), ncol = p)
outliers <- matrix(runif(20, min = 5, max = 8), ncol = p)
dataset <- rbind(datos_sanos, outliers)

# 2. Ajuste del modelo MCD
modelo_mcd <- covMcd(dataset, alpha = 0.75)

# 3. Distancias robustas y detección
distancias_mcd <- modelo_mcd$mah
umbral_critico <- qchisq(0.975, df = p)
indices_outliers_mcd <- which(distancias_mcd > umbral_critico)

cat("Outliers detectados por MCD:", length(indices_outliers_mcd), "\n")- Algoritmo BACON
BACON (Blocked Adaptive Computationally-efficient Outlier Nominator)
- Inicialización: Se selecciona un subconjunto inicial \(H_0\) de tamaño \(m_0 = c \cdot p\) (usualmente con \(c=4\) o \(c=5\)), integrado por las observaciones con menor distancia respecto a un estimador inicial no paramétrico (como la mediana multivariante).
- Estimación: En la iteración \(k\), se calcula la media \(\bar{x}_{H_k}\) y la matriz de covarianza \(\mathbf{S}_{H_k}\) solo con los elementos de \(H_k\).
- Distancia: Se calcula la distancia de Mahalanobis para todas las \(n\) observaciones de la base de datos respecto al bloque actual:
\[d_i(k) = \sqrt{(x_i - \bar{x}_{H_k})^T \mathbf{S}_{H_k}^{-1} (x_i - \bar{x}_{H_k})}\]
- Actualización: Se redefine el subconjunto \(H_{k+1}\) incluyendo a todos los puntos cuya distancia cumple:
\[d_i(k) < c_{n,p} \sqrt{\chi^2_{p,\, 1 - \alpha/n}}\]
(donde \(c_{n,p}\) representa un factor de corrección de tamaño muestral). 5. Convergencia: El ciclo se repite hasta que el conjunto no cambie (\(H_{k+1} = H_k\)). Todos los puntos fuera de \(H_{\text{final}}\) son declarados atípicos.
Ejemplo en R (BACON)
install.packages("wbacon")
library(wbacon)

# 1. Aplicación sobre el mismo dataset
modelo_bacon <- bacon(dataset, alpha = 0.05)

# 2. Identificación de outliers (elementos fuera del subconjunto final)
indices_outliers_bacon <- which(!modelo_bacon$subset)

cat("Outliers detectados por BACON:", length(indices_outliers_bacon), "\n")
5.2.2.3 Listado de Enfoques Avanzados de Detección Multivariante
Los siguientes métodos algorítmicos serán desarrollados en profundidad en los capítulos correspondientes de modelado no supervisado:
- Análisis de Componentes Principales (PCA): Detección basada en las puntuaciones de las primeras componentes (outliers estructurales) o de las últimas componentes (violaciones a las correlaciones lineales) .
- Algoritmos de agrupamiento: Los outliers multivariantes se asocian en algún grupo.
Contexto: Un analista de riesgos desea detectar fraudes en transacciones utilizando dos atributos: “Monto de Retiro” (escala de 0 a 5,000 BOB) y “Cantidad de Retiros Diarios” (escala de 0 a 10).
Instrucción: Analice la situación y responda:
- Si un usuario realiza un retiro inusual de 4,500 BOB (cerca del límite univariante), ¿por qué este registro podría ocultar un fraude multivariante si no evaluamos su correlación con la cantidad de retiros realizados en la última hora?.
- ¿Por qué la distancia euclidiana simple fallaría en detectar anomalías en este escenario si no escalamos previamente ambas variables?.
5.3 Tratamiento de Valores Perdidos (Missing Data)
5.3.1 Aproximación Formal e Identificación de Mecanismos
Para estructurar matemáticamente el problema de los datos incompletos, definimos una base de datos como una matriz \(Y\) de dimensiones \(n \times p\). Sea \(R\) una matriz de respuesta binaria de dimensiones idénticas, donde cada elemento \(r_{ij} = 1\) si el valor de la variable \(y_{ij}\) fue observado, y \(r_{ij} = 0\) si es un dato perdido. Los valores observados se agrupan en el conjunto \(Y_{obs}\), mientras que los registros omitidos se denotan como \(Y_{mis}\), de modo que \(Y = (Y_{obs}, Y_{mis})\).
La probabilidad de pérdida de datos se modela bajo una distribución condicional parametrizada por \(\psi\), expresada como \(\Pr(R \mid Y_{obs}, Y_{mis}, \psi)\). Basándonos en esta formulación, clasificamos los procesos de pérdida en tres mecanismos fundamentales:
- Pérdida Completamente al Azar (MCAR - Missing Completely at Random): La probabilidad de que un dato se pierda es totalmente independiente de los valores de las variables (sean observadas o perdidas). \[\Pr(R = 0 \mid Y_{obs}, Y_{mis}, \psi) = \Pr(R = 0 \mid \psi)\]
- Pérdida al Azar (MAR - Missing at Random): La probabilidad de pérdida no depende de los valores omitidos \(Y_{mis}\), pero sí puede explicarse por completo a través de otras variables observadas en el dataset (\(Y_{obs}\)). \[\Pr(R = 0 \mid Y_{obs}, Y_{mis}, \psi) = \Pr(R = 0 \mid Y_{obs}, \psi)\]
- Pérdida No al Azar (MNAR - Missing Not at Random): La probabilidad de que un registro sea omitido depende directamente del valor que hubiese tomado la variable no observada. Es un mecanismo no ignorable que requiere un modelado explícito de la causa de pérdida. \[\Pr(R = 0 \mid Y_{obs}, Y_{mis}, \psi)\]
5.3.2 Diagnóstico de Patrones de Pérdida con R (mice)
Antes de seleccionar una estrategia de imputación, es recomendable aplicar pruebas de diagnóstico visual y estadístico para entender la estructura de la pérdida. El paquete mice (Multivariate Imputation by Chained Equations) proporciona herramientas potentes para examinar la distribución de los datos faltantes.
La función md.pattern() permite visualizar y retornar la matriz de patrones de pérdida, mostrando qué combinaciones de variables faltantes se presentan con mayor frecuencia y cómo se agrupan las observaciones incompletas.
library(mice)
# Visualizar el patrón de datos perdidos
md.pattern(airquality)
5.3.3 Conectividad de la Pérdida: Influx y Outflux
Para evaluar la viabilidad de la imputación en un dataset multivariado, se emplean los coeficientes de Influx (\(I_j\)) y Outflux (\(O_j\)) desarrollados por van Buuren. Estas métricas cuantifican la fuerza de conexión de cada variable dentro del sistema de datos faltantes:
- Influx (\(I_j\)): Mide qué tan bien conectada está una variable incompleta con los datos observados de las demás variables. Una variable con mayor \(I_j\) es más fácil de imputar debido a que cuenta con un fuerte respaldo de datos observados en su vecindad algorítmica.
\[I_j = \frac{\sum_j^p\sum_k^p\sum_i^n (1-r_{ij})r_{ik}}{\sum_k^p\sum_i^n r_{ik}}\] * Outflux (\(O_j\)): Cuantifica la utilidad de una variable para servir como predictora en los modelos de imputación de otras variables faltantes. Una variable con alto \(O_j\) es un activo predictivo valioso dentro del flujo de trabajo de imputación múltiple.
\[O_j = \frac{\sum_j^p\sum_k^p\sum_i^n r_{ij}(1-r_{ik})}{\sum_k^p\sum_i^n 1-r_{ij}}\]
El cálculo y visualización de estas métricas se realiza de manera directa utilizando la función flux() del paquete mice:
library(mice)
flux(airquality)
Es posible generar un “fluxplot” para posicionar visualmente cada variable en función de su Influx y Outflux, facilitando la toma de decisiones sobre qué variables retener o priorizar en los modelos:
# Graficar el flujo de datos faltantes
fluxplot(airquality, main = "Gráfico de Diagnóstico de Influx y Outflux")Escenario: Imagine que un dataset bancario muestra que la variable “Historial de Pagos” posee un alto Influx (\(I_j \approx 0.85\)) pero un bajo Outflux (\(O_j \approx 0.12\)), mientras que la variable “Nivel de Ingresos” muestra la tendencia opuesta. 1. Pregunta: ¿Cuál de las dos variables será más fácil de imputar con alta precisión? 2. Pregunta: Si planea construir modelos predictivos para estimar otras variables del dataset, ¿cuál de las dos variables aportará mayor estabilidad y poder predictor para las imputaciones?.
Ejemplo en R:
library(mice)
library(naniar)
datos <- airquality
# A. OBTENER LA MATRIZ DE RESPUESTA
matriz_R <- is.na(datos) * 1
head(matriz_R)
patrones <- md.pattern(datos, plot = TRUE)
print(patrones)
# B. PRUEBA ESTADÍSTICA PARA MCAR (Test de Little)
# El Test de Little evalúa la hipótesis nula (H0): Los datos son MCAR.
test_little <- mcar_test(datos)
print(test_little)
mcar_test(datos[,c("Ozone", "Temp")])
# C. DIAGNÓSTICO VISUAL PARA MAR
# Si los datos no son MCAR, ¿cómo vemos si son MAR?
# Margin plot de VIM (muy útil en conjunto con mice)
library(VIM)
marginplot(datos[, c("Ozone", "Temp")],
           main = "Dependencia entre ausencia de Ozono y Temperatura")
# Si los diagramas de caja rojos (faltantes) y azules (observados) son muy distintos,
# la pérdida en Ozono depende fuertemente de la Temperatura (Evidencia de MAR).
5.3.4 Técnicas de Imputación Clásicas (Ad-Hoc)
La literatura estadística clásica provee soluciones directas de fácil implementación computacional, las cuales resultan idóneas en este punto del curso debido a que no exigen el entrenamiento de modelos de machine learning avanzados:
- Eliminación por Filas (Listwise Deletion): Consiste en descartar por completo cualquier observación que contenga al menos un valor perdido. Solo es metodológicamente válida si el mecanismo es estrictamente MCAR y el tamaño de la pérdida es insignificante.
- Imputación por Tendencia Central (Media o Mediana): Reemplaza las celdas vacías por la media o mediana de la parte observada de la misma variable. Su gran riesgo es que reduce artificialmente la varianza de la variable, distorsionando la estructura estadística original (Shmueli et al. 2018).
- Imputación por Regresión Simple: Construye un modelo lineal clásico (
lm()) donde la variable con datos perdidos actúa como variable objetivo y se predice a partir de variables observadas completas.
5.3.5 Listado Conceptual de Métodos de Imputación Avanzados
- Imputación No Supervisada por Vecinos Cercanos (k-NN): Estima el valor perdido calculando la media ponderada de los \(k\) registros geométricamente más similares.
- Regresión Estocástica: Reintroduce la variabilidad natural sumando un término de ruido aleatorio (\(\epsilon \sim N(0, \sigma^2)\)) extraído de los residuos de la regresión.
- Imputación Múltiple (MICE): Genera múltiples datasets imputados combinando ecuaciones totalmente condicionales, permitiendo modelar la incertidumbre de la imputación de manera formal.
- Diagnóstico Visual de Datos Perdidos: Cargue las variables numéricas del dataset
algaedeDMwR2. Utilice el comandomd.pattern()del paquetemicepara extraer la matriz de patrones de datos perdidos y responda:- ¿Cuántas observaciones completas (complete cases) registra el dataset?.
- ¿Qué combinación o patrón de variables faltantes se presenta con mayor frecuencia?
- Cálculo Analítico de Flujo con mice: Utilizando las variables continuas de
algae:- Ejecute el cálculo de flujo con
mice::flux(). - Identifique las variables con el mayor Influx y el mayor Outflux.
- Interprete cuál de las variables continuas es el mejor candidato predictor para entrenar modelos de imputación y cuál se beneficiaría más de la imputación basada en la vecindad.
- Ejecute el cálculo de flujo con